mobile wallpaper 1
mobile wallpaper 2
mobile wallpaper 3
mobile wallpaper 4
mobile wallpaper 5
mobile wallpaper 6
4447 字
11 分钟
常见概率分布

本文主要对概率论与数理统计里常见的各类概率分布进行系统的梳理。在学习这一章时,核心思路可以总结为:

先明确随机变量是离散型还是连续型,再牢记每种分布所适合描述的实际场景\boxed{\text{先明确随机变量是离散型还是连续型,再牢记每种分布所适合描述的实际场景}}

1. 概率分布的总分类#

随机变量的概率分布主要可以划分为以下三大类:

分布类别核心数学特点常见典型分布
离散型分布随机变量的可能取值是有限个或可列无限个两点分布、二项分布、几何分布、超几何分布、泊松分布
连续型分布随机变量可以在某一个或多个实数区间内连续取值均匀分布、指数分布、正态分布
抽样分布数理统计中用于推断未知参数的统计量所服从的分布卡方分布、学生分布(tt 分布)、FF 分布

2. 常见离散型分布#

2.1 两点分布 / 伯努利分布#

若随机变量 XX 只能取两个值 00 和 11,且其发生的概率分别为:

P(X=1)=p,P(X=0)=1−p(0<p<1)P(X = 1) = p, \quad P(X = 0) = 1 - p \quad (0 < p < 1)

则称 XX 服从两点分布,也称为伯努利分布。

记作:

X∼B(1,p)X \sim B(1, p)

其概率质量函数(分布律)可以统一表示为:

P(X=x)=px(1−p)1−x,x=0,1P(X = x) = p^x(1 - p)^{1 - x}, \quad x = 0, 1

数学期望与方差分别为:

E(X)=pE(X) = pD(X)=p(1−p)D(X) = p(1 - p)

典型适用场景#

  • 一次射击试验:命中(1)或未命中(0);
  • 一次产品质量抽查:合格(1)或不合格(0);
  • 一次选举投票:支持(1)或不支持(0);
  • 一次科学试验:成功(1)或失败(0)。

简明规律:

两点分布描述的是单次试验中成败这一最基础的随机事件\boxed{\text{两点分布描述的是单次试验中成败这一最基础的随机事件}}

2.2 二项分布#

若进行 nn 次独立重复的伯努利试验,每次试验中事件成功的概率均为 pp。令随机变量 XX 表示 nn 次试验中成功的次数,则 XX 服从二项分布。

记作:

X∼B(n,p)X \sim B(n, p)

其分布律公式为:

P(X=k)=Cnkpk(1−p)n−k,k=0,1,2,…,n\boxed{P(X = k) = C_n^k p^k(1 - p)^{n - k}, \quad k = 0, 1, 2, \dots, n}

数学期望与方差分别为:

E(X)=npE(X) = npD(X)=np(1−p)D(X) = np(1 - p)

典型适用场景#

  • 独立重复射击 nn 次,射中目标的次数;
  • 重复抛掷一枚硬币 nn 次,正面朝上的次数;
  • 从大批工业产品中随机抽检 nn 件,其中所包含的次品个数;
  • 独立作答 nn 道单选题,最终答对的题目数。

计算示例#

假设某射击运动员每次射击的命中率均为 0.8。现独立射击 5 次,令随机变量 XX 表示命中的次数,则 X∼B(5,0.8)X \sim B(5, 0.8)。

其恰好命中 3 次的概率计算为:

P(X=3)=C53(0.8)3(0.2)2=10⋅0.512⋅0.04=0.2048P(X = 3) = C_5^3 (0.8)^3 (0.2)^2 = 10 \cdot 0.512 \cdot 0.04 = 0.2048

简明规律:

二项分布描述的是 n 次独立重复试验中成功发生的总次数\boxed{\text{二项分布描述的是 } n \text{ 次独立重复试验中成功发生的总次数}}二项分布概率质量分布图

2.3 几何分布#

若每次试验成功的概率为 pp,在独立重复试验中,令随机变量 XX 表示为了获得首次成功所需要的累计试验次数,则 XX 服从几何分布。

其分布律公式为:

P(X=k)=(1−p)k−1p,k=1,2,3,…\boxed{P(X = k) = (1 - p)^{k - 1}p, \quad k = 1, 2, 3, \dots}

数学期望与方差分别为:

E(X)=1pE(X) = \frac{1}{p}D(X)=1−pp2D(X) = \frac{1 - p}{p^2}

典型适用场景#

  • 重复射击,直到第几次射击才出现首次命中;
  • 重复参与抽奖,直到第几次才首次中奖;
  • 连续质检产品,直到第几件才首次发现次品。

计算示例#

某人投篮的命中率为 0.6。问其直到第 3 次投篮才首次投中的概率。

根据几何分布定义,前 2 次必须未投中,第 3 次投中:

P(X=3)=(1−0.6)3−1⋅0.6=(0.4)2⋅0.6=0.096P(X = 3) = (1 - 0.6)^{3 - 1} \cdot 0.6 = (0.4)^2 \cdot 0.6 = 0.096

简明规律:

几何分布描述的是在独立重复试验中,首次成功出现时的等待次数\boxed{\text{几何分布描述的是在独立重复试验中,首次成功出现时的等待次数}}
  • 注意:部分国外教材或特定考题将 XX 定义为“首次成功前所失败的次数”,此时随机变量的取值范围为 k=0,1,2,…k = 0, 1, 2, \dots,其分布律公式会变更为 P(X=k)=(1−p)kpP(X = k) = (1 - p)^k p。在审题时务必看清变量的具体定义。

2.4 超几何分布#

超几何分布用于描述在不放回抽样条件下的概率问题。

设总体共包含 NN 个个体,其中有 MM 个属于成功类,剩下的 N−MN - M 个属于失败类。现从中不放回地随机抽取 nn 个个体,令随机变量 XX 表示抽出的个体中属于成功类的个数,则 XX 服从超几何分布。

其分布律公式为:

P(X=k)=CMkCN−Mn−kCNn\boxed{P(X = k) = \frac{C_M^k C_{N - M}^{n - k}}{C_N^n}}

其取值的合理范围为 max⁡(0,n−N+M)≤k≤min⁡(n,M)\max(0, n - N + M) \le k \le \min(n, M)。

数学期望与方差为:

E(X)=nMNE(X) = n\frac{M}{N}D(X)=nMN(1−MN)N−nN−1D(X) = n\frac{M}{N}\left(1 - \frac{M}{N}\right)\frac{N - n}{N - 1}

典型适用场景#

  • 一箱共 NN 件产品中含有 MM 件次品,不放回地随机抽出 nn 件,求抽到的次品个数;
  • 从装有红球和白球的袋子中,不放回地摸出若干个球,求摸出红球的个数;
  • 从包含男女生的班级中,不放回地随机抽取若干人,求其中女生的人数。

计算示例#

一批共 20 件产品中含有 5 件次品。现从中不放回地随机抽取 4 件,求恰好抽到 2 件次品的概率。

P(X=2)=C52C152C204P(X = 2) = \frac{C_5^2 C_{15}^2}{C_{20}^4}

简明规律:

超几何分布描述的是在有限总体中进行不放回抽样时,抽中特定类别的个数\boxed{\text{超几何分布描述的是在有限总体中进行不放回抽样时,抽中特定类别的个数}}

2.5 泊松分布#

如果随机变量 XX 表示在某段特定的时间、空间或区域内,某随机事件发生的次数,且该事件平均发生的次数为 λ\lambda,则 XX 服从泊松分布。

记作:

X∼P(λ)X \sim P(\lambda)

其分布律公式为:

P(X=k)=λkk!e−λ,k=0,1,2,…\boxed{P(X = k) = \frac{\lambda^k}{k!}e^{-\lambda}, \quad k = 0, 1, 2, \dots}

数学期望与方差满足特征:

E(X)=λ,D(X)=λE(X) = \lambda, \quad D(X) = \lambda

典型适用场景#

  • 某繁忙路口在一分钟内通过的车辆总数;
  • 某零售商铺在一天内迎来光顾的顾客总数;
  • 某生产设备在一小时内发生故障的次数;
  • 某书籍页面中印刷错误的字符数;
  • 某特定地区在一天内发生交通事故的次数。

计算示例#

某客服热线中心平均每分钟接到 3 个来电,求其在一分钟内恰好接到 2 个来电的概率。

此随机发生次数服从泊松分布 X∼P(3)X \sim P(3):

P(X=2)=322!e−3=4.5e−3P(X = 2) = \frac{3^2}{2!}e^{-3} = 4.5 e^{-3}

简明规律:

泊松分布描述的是在连续的单位时间或区域内,稀有随机事件发生的频数\boxed{\text{泊松分布描述的是在连续的单位时间或区域内,稀有随机事件发生的频数}}泊松分布概率质量分布图

3. 常见连续型分布#

3.1 均匀分布#

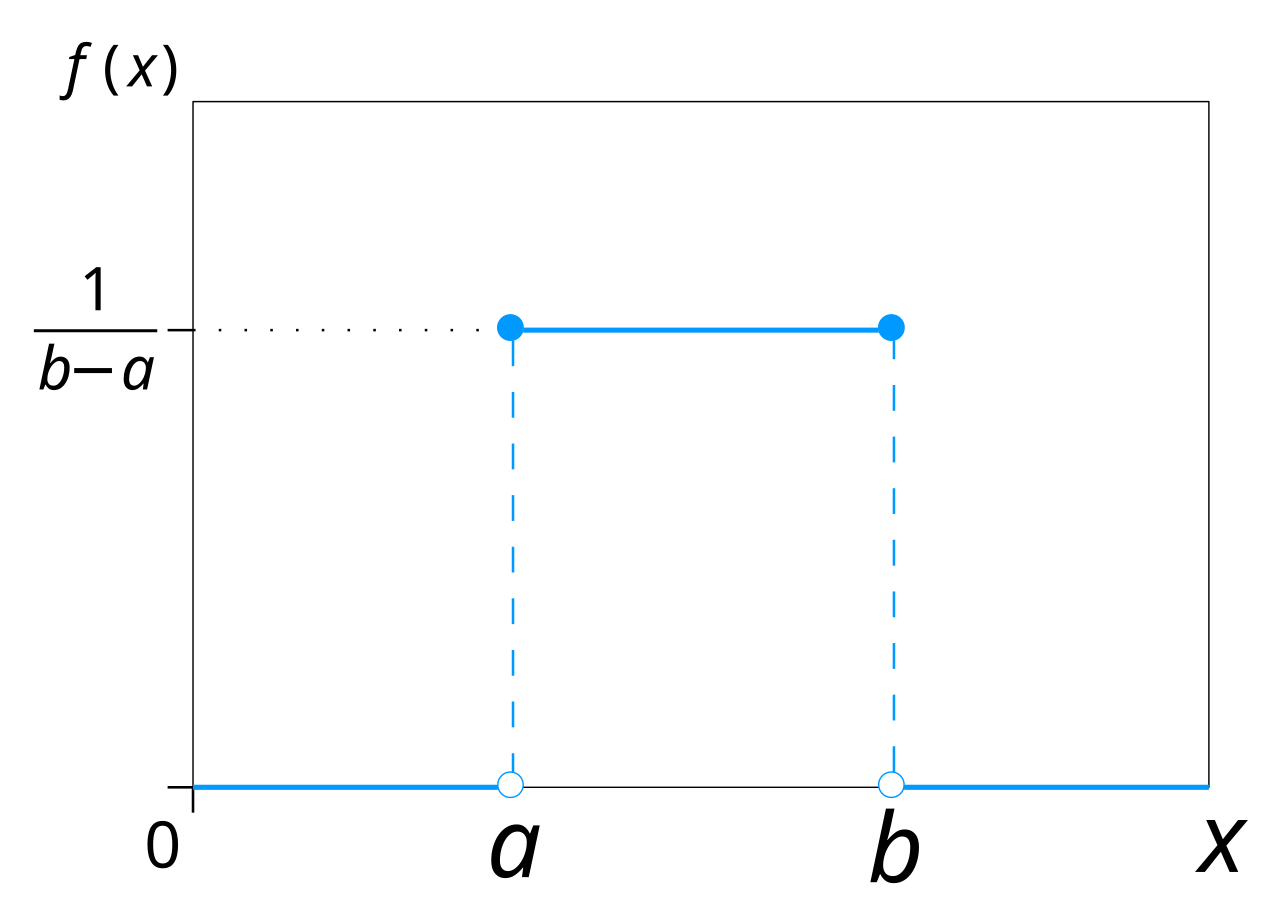
若随机变量 XX 在实数区间 [a,b][a, b] 上取值,且落在该区间内任意等长度子区间内的概率均相等,则称 XX 在区间 [a,b][a, b] 上服从均匀分布。

记作:

X∼U(a,b)X \sim U(a, b)

其概率密度函数为:

f(x)={1b−a,a<x<b0,其他f(x) = \begin{cases} \dfrac{1}{b-a}, & a < x < b \\ 0, & \text{其他} \end{cases}

累积分布函数为:

F(x)={0,x<ax−ab−a,a≤x<b1,x≥bF(x) = \begin{cases} 0, & x < a \\ \dfrac{x - a}{b - a}, & a \le x < b \\ 1, & x \ge b \end{cases}

数学期望与方差分别为:

E(X)=a+b2E(X) = \frac{a + b}{2}D(X)=(b−a)212D(X) = \frac{(b - a)^2}{12}

典型适用场景#

  • 某线路公交车每 10 分钟一班,某人随机到达站台,其等待公交车的时间;
  • 计算机生成的伪随机数;
  • 测量仪器读数四舍五入带来的舍入误差。

计算示例#

已知公交车每 10 分钟发车一班,某乘客随机到达车站,其等待时间服从均匀分布 X∼U(0,10)X \sim U(0, 10)。求该乘客等待时间不超过 3 分钟的概率。

P(X≤3)=3−010−0=0.3P(X \le 3) = \frac{3 - 0}{10 - 0} = 0.3

简明规律:

均匀分布描述的是在确定区间内,取值机会完全均等的连续型分布\boxed{\text{均匀分布描述的是在确定区间内,取值机会完全均等的连续型分布}}均匀分布概率密度函数图

3.2 指数分布#

指数分布常用于描述设备寿命或随机服务系统中的等待时间。

如果随机变量服从指数分布:

X∼E(λ)(λ>0)X \sim E(\lambda) \quad (\lambda > 0)

其概率密度函数为:

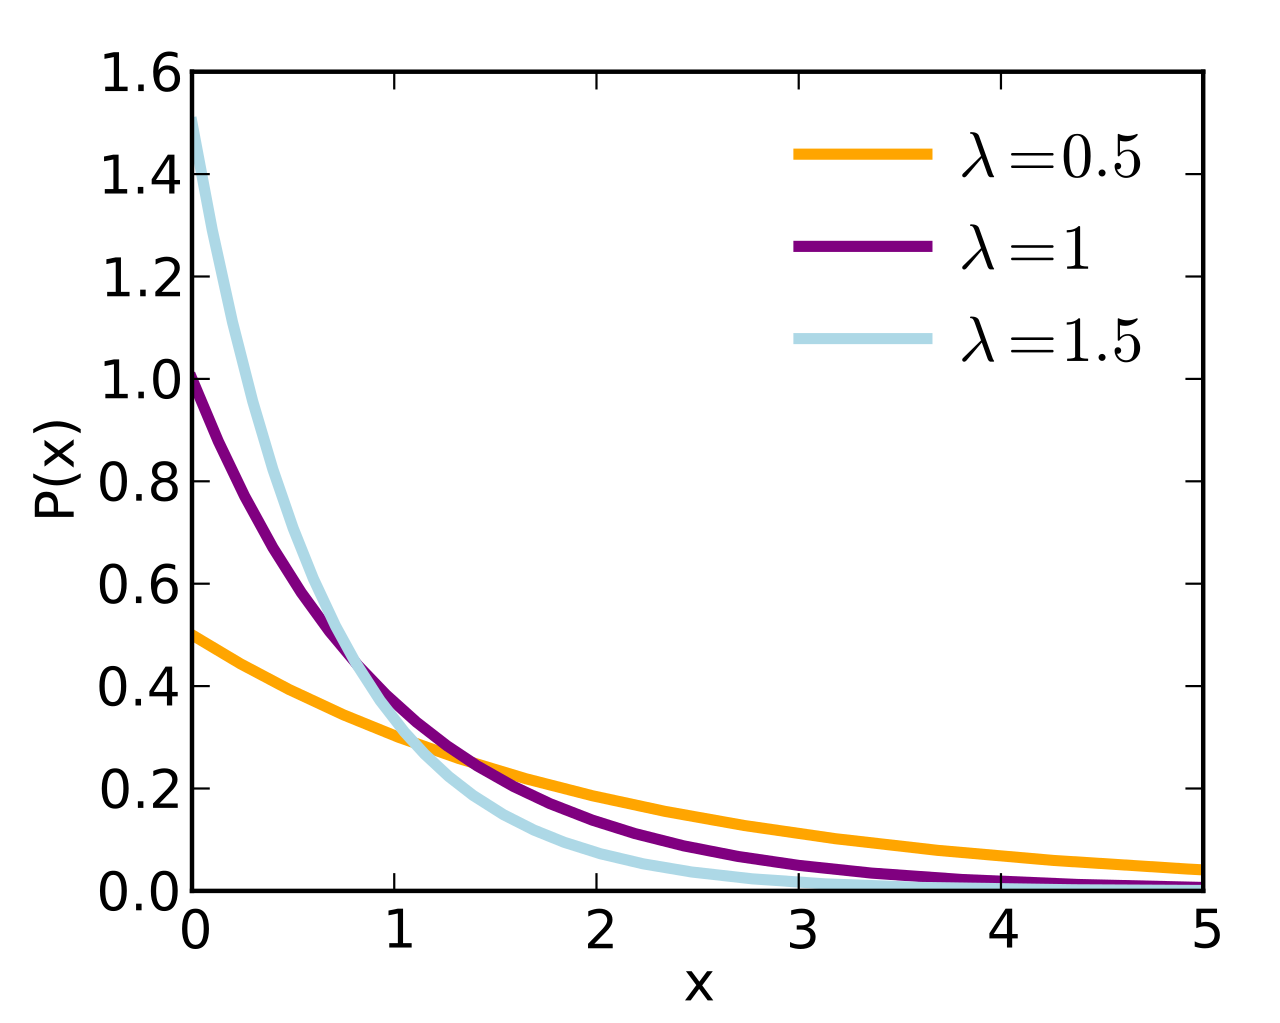
f(x)={λe−λx,x>00,x≤0f(x) = \begin{cases} \lambda e^{-\lambda x}, & x > 0 \\ 0, & x \le 0 \end{cases}

其累积分布函数为:

F(x)={1−e−λx,x>00,x≤0F(x) = \begin{cases} 1 - e^{-\lambda x}, & x > 0 \\ 0, & x \le 0 \end{cases}

在实际计算中,我们常用其右尾生存概率公式:

P(X>x)=e−λx(x>0)\boxed{P(X > x) = e^{-\lambda x} \quad (x > 0)}

数学期望与方差分别为:

E(X)=1λE(X) = \frac{1}{\lambda}D(X)=1λ2D(X) = \frac{1}{\lambda^2}
  • 这里的参数 λ\lambda 代表单位时间内事件发生的平均速率。

典型适用场景#

  • 某电子元器件或机械设备的物理使用寿命;
  • 电话中心等待下一个呼入电话所经历的时间;
  • 排队论中,等待下一位顾客到店的服务间隔时间。

计算示例#

某精密仪器平均使用寿命为 1000 小时。假设其寿命服从指数分布,求该仪器使用寿命超过 1500 小时的概率。

因为平均寿命 E(X)=1λ=1000E(X) = \dfrac{1}{\lambda} = 1000,解得率参数 λ=11000\lambda = \dfrac{1}{1000}。

仪器寿命超过 1500 小时的概率为:

P(X>1500)=e−15001000=e−1.5P(X > 1500) = e^{-\frac{1500}{1000}} = e^{-1.5}

简明规律:

指数分布描述的是无记忆性的等待时间或使用寿命\boxed{\text{指数分布描述的是无记忆性的等待时间或使用寿命}}指数分布概率密度函数图

核心性质:无记忆性#

指数分布是唯一的具有无记忆性的连续型概率分布,满足如下条件:

P(X>s+t∣X>s)=P(X>t)(s,t>0)P(X > s + t \mid X > s) = P(X > t) \quad (s, t > 0)

这在直观上的物理含义是:对于一个正常工作的元器件,它已经工作了 ss 小时这一事实,并不影响它能继续工作 tt 小时的概率。它在任何时刻都“宛如新生”。


3.3 正态分布#

正态分布是概率论与数理统计中应用最为广泛、最重要的连续型随机变量分布。

如果随机变量服从正态分布:

X∼N(μ,σ2)(σ>0)X \sim N(\mu, \sigma^2) \quad (\sigma > 0)

其概率密度函数为经典的钟形曲线:

f(x)=12πσe−(x−μ)22σ2\boxed{f(x) = \frac{1}{\sqrt{2\pi}\sigma} e^{-\frac{(x - \mu)^2}{2\sigma^2}}}

数学期望与方差分别为:

E(X)=μ,D(X)=σ2E(X) = \mu, \quad D(X) = \sigma^2

曲线的几何特征#

  • 曲线呈单峰钟形,关于直线 x=μx = \mu 左右对称;
  • 参数 μ\mu 决定了分布中心的位置;
  • 参数 σ\sigma 控制了曲线的离散波动程度。σ\sigma 越大,曲线越扁平宽分散;σ\sigma 越小,说明数据越集中,曲线越尖锐窄高。

典型适用场景#

  • 成年人群的身高与体重数据;
  • 某次标准化考试中考生的考试成绩;
  • 物理测量过程中不可避免的测量误差;
  • 机械加工中零件的尺寸误差;
  • 受到自然界大量独立、微小的随机因素共同叠加作用所产生的数据分布。

简明规律:

正态分布描述的是受大量微小随机独立因素共同作用后的连续分布状态\boxed{\text{正态分布描述的是受大量微小随机独立因素共同作用后的连续分布状态}}正态分布概率密度函数钟形曲线图

3.4 标准正态分布与标准化法#

当正态分布满足均值 μ=0\mu = 0,方差 σ2=1\sigma^2 = 1 时,特称为标准正态分布。

通常记为:

Z∼N(0,1)Z \sim N(0, 1)

其概率密度函数与累积分布函数分别记为:

φ(x)=12πe−x22\varphi(x) = \frac{1}{\sqrt{2\pi}}e^{-\frac{x^2}{2}}Φ(x)=P(Z≤x)=∫−∞xφ(t) dt\Phi(x) = P(Z \le x) = \int_{-\infty}^{x} \varphi(t)\,dt

标准化定理#

对于任意一般的正态分布随机变量 X∼N(μ,σ2)X \sim N(\mu, \sigma^2),我们可以通过线性变换将其转化为标准正态变量:

Z=X−μσ∼N(0,1)\boxed{Z = \frac{X - \mu}{\sigma} \sim N(0, 1)}

这一标准化过程是求解正态分布概率的核心工具。

例如,计算 XX 落在区间 (a,b)(a, b) 内的概率:

P(a<X<b)=P(a−μσ<Z<b−μσ)=Φ(b−μσ)−Φ(a−μσ)\begin{aligned} P(a < X < b) &= P\left(\frac{a - \mu}{\sigma} < Z < \frac{b - \mu}{\sigma}\right) \\ &= \Phi\left(\frac{b - \mu}{\sigma}\right) - \Phi\left(\frac{a - \mu}{\sigma}\right) \end{aligned}

简明规律:

求解一般正态分布概率,第一步一定是将其标准化\boxed{\text{求解一般正态分布概率,第一步一定是将其标准化}}

4. 数理统计中的三大抽样分布#

数理统计中的三大抽样分布是由正态分布衍生出来的,在参数估计与假设检验中扮演着枢轴量的角色。


4.1 卡方分布#

设随机变量 Z1,Z2,…,ZnZ_1, Z_2, \dots, Z_n 相互独立,且均服从标准正态分布 Zi∼N(0,1)Z_i \sim N(0, 1)。

则它们平方和所构成的新随机变量:

X=Z12+Z22+⋯+Zn2\boxed{X = Z_1^2 + Z_2^2 + \dots + Z_n^2}

服从自由度为 nn 的卡方分布,记作:

X∼χ2(n)X \sim \chi^2(n)

其数学期望与方差分别为:

E(X)=nE(X) = nD(X)=2nD(X) = 2n

核心应用定理#

在正态总体样本中,样本方差 S2S^2 与总体方差 σ2\sigma^2 之间满足如下结论:

(n−1)S2σ2∼χ2(n−1)\boxed{\frac{(n-1)S^2}{\sigma^2} \sim \chi^2(n-1)}

这为估计和检验总体方差提供了理论依据。

简明规律:

χ2 分布主要用于解决与正态总体方差相关的估算与检验问题\boxed{\chi^2 \text{ 分布主要用于解决与正态总体方差相关的估算与检验问题}}卡方分布概率密度函数图

4.2 学生分布(tt 分布)#

设随机变量 Z∼N(0,1)Z \sim N(0, 1),随机变量 U∼χ2(n)U \sim \chi^2(n),且 ZZ 与 UU 相互独立。

则新随机变量:

T=ZU/n\boxed{T = \frac{Z}{\sqrt{U / n}}}

服从自由度为 nn 的 tt 分布,记作:

T∼t(n)T \sim t(n)

分布特征#

  • 曲线关于 T=0T = 0 对称,形状类似于标准正态分布,但比标准正态分布具有“更厚”的尾部;
  • 当自由度 n→∞n \to \infty 时,t(n)t(n) 分布在极限下收敛于标准正态分布 N(0,1)N(0, 1)。

核心应用定理#

当正态总体方差 σ2\sigma^2 未知时,样本均值与样本标准差满足如下结论:

X‾−μS/n∼t(n−1)\boxed{\frac{\overline{X} - \mu}{S / \sqrt{n}} \sim t(n - 1)}

这为单总体及双总体的均值推断奠定了基础。

简明规律:

t 分布主要用于在方差未知的前提下,处理与均值相关的估算与检验\boxed{t \text{ 分布主要用于在方差未知的前提下,处理与均值相关的估算与检验}}t分布概率密度函数图

4.3 FF 分布#

设随机变量 U∼χ2(m)U \sim \chi^2(m),随机变量 V∼χ2(n)V \sim \chi^2(n),且 UU 与 VV 相互独立。

则这两个卡方统计量除以各自自由度之后的比值:

F=U/mV/n\boxed{F = \frac{U / m}{V / n}}

服从第一自由度为 mm,第二自由度为 nn 的 FF 分布,记作:

F∼F(m,n)F \sim F(m, n)

核心应用定理#

从两个独立正态总体中抽样,其样本方差之比满足结论:

S12/σ12S22/σ22∼F(n1−1,n2−1)\boxed{\frac{S_1^2 / \sigma_1^2}{S_2^2 / \sigma_2^2} \sim F(n_1 - 1, n_2 - 1)}

这可直接用于推断两个总体方差是否相等。

简明规律:

F 分布主要用于比较两个正态总体的方差大小关系\boxed{F \text{ 分布主要用于比较两个正态总体的方差大小关系}}F分布概率密度函数图

5. 各种概率分布之间的深层联系#

不同的分布之间存在着紧密的内在转换与极限近似关系:

graph TD Bernoulli["两点分布"] -->|n次独立试验| Binomial["二项分布"] Binomial -->|n很大且p极小| Poisson["泊松分布"] Binomial -->|n很大且期望较大| Normal["正态分布"] Poisson -->|均值较大时| Normal Normal -->|标准化变换| StdNormal["标准正态分布"] StdNormal -->|独立变量平方和| ChiSquare["卡方分布"] StdNormal & ChiSquare -->|比值构成统计量| TDist["t 分布"] ChiSquare & ChiSquare -->|比值构成统计量| FDist["F 分布"] TDist -->|自由度趋于无穷| StdNormal

1. 两点分布与二项分布#

两点分布是二项分布当试验次数 n=1n = 1 时的特例,即二项分布可以看作是 nn 个独立同分布的两点分布随机变量之和。

2. 二项分布与泊松分布的极限(泊松定理)#

当二项分布中试验次数 nn 非常大(如 n≥100n \ge 100),且单次成功概率 pp 非常小(如 p≤0.1p \le 0.1),而乘积 λ=np\lambda = np 保持稳定时,二项分布可近似为泊松分布:

B(n,p)≈P(np)B(n, p) \approx P(np)

这常被用于计算稀有突发事件的概率。

3. 二项分布的正态近似(棣莫弗-拉普拉斯定理)#

当二项分布的 nn 较大且 npnp 与 n(1−p)n(1-p) 均较大(通常大于 5)时,二项分布可近似为正态分布:

X≈N(np,np(1−p))X \approx N\left(np, np(1 - p)\right)

在实际近似计算中,为提高精确度,通常需要对区间进行连续性校正。例如,将 P(X≤k)P(X \le k) 校正为 P(X<k+0.5)P(X < k + 0.5) 后再进行标准化计算。

4. 泊松分布的正态近似#

当泊松分布的均值参数 λ\lambda 较大(如 λ≥20\lambda \ge 20)时,泊松分布也可以近似为正态分布:

X≈N(λ,λ)X \approx N(\lambda, \lambda)

5. 抽样分布的起源#

三大抽样分布 χ2\chi^2 分布、tt 分布与 FF 分布,其数学构造的源头全部来自于独立的标准正态分布变量 N(0,1)N(0, 1)。


6. 常见概率分布速查总表#

分布名称常用记号随机变量取值范围数学期望 E(X)E(X)物理方差 D(X)D(X)典型应用领域
两点分布B(1,p)B(1, p){0,1}\{0, 1\}ppp(1−p)p(1 - p)一次成败试验
二项分布B(n,p)B(n, p){0,1,…,n}\{0, 1, \dots, n\}npnpnp(1−p)np(1 - p)重复抽样、成败计数
几何分布G(p)G(p){1,2,… }\{1, 2, \dots\}1p\dfrac{1}{p}1−pp2\dfrac{1 - p}{p^2}首次成功的等待次数
超几何分布H(N,M,n)H(N, M, n)合理整数组合 kknMNn\dfrac{M}{N}nMN(1−MN)N−nN−1n\dfrac{M}{N}\left(1 - \dfrac{M}{N}\right)\dfrac{N - n}{N - 1}不放回抽样质检
泊松分布P(λ)P(\lambda){0,1,2,… }\{0, 1, 2, \dots\}λ\lambdaλ\lambda单位时间或区域发生频数
均匀分布U(a,b)U(a, b)[a,b][a, b]a+b2\dfrac{a + b}{2}(b−a)212\dfrac{(b - a)^2}{12}区间等概率取值、随机等待
指数分布E(λ)E(\lambda)[0,+∞)[0, +\infty)1λ\dfrac{1}{\lambda}1λ2\dfrac{1}{\lambda^2}设备物理寿命、服务间隔
正态分布N(μ,σ2)N(\mu, \sigma^2)(−∞,+∞)(-\infty, +\infty)μ\muσ2\sigma^2测量误差、身高、自然现象
卡方分布χ2(n)\chi^2(n)[0,+∞)[0, +\infty)nn2n2n正态总体方差推断
tt 分布t(n)t(n)(−∞,+∞)(-\infty, +\infty)0(n>1)0 \quad (n>1)nn−2(n>2)\dfrac{n}{n - 2} \quad (n>2)方差未知时的均值推断
FF 分布F(m,n)F(m, n)[0,+∞)[0, +\infty)nn−2(n>2)\dfrac{n}{n - 2} \quad (n>2)较复杂两个总体方差的对比推断

7. 实际做题时如何选择分布#

在面对概率论应用题时,可以通过题目中的关键性线索锁定所使用的分布类型:

  1. “仅有一次且只有两种结果”   ⟹  \implies 选用 两点分布;
  2. “独立重复进行 nn 次,求解成功了多少次”   ⟹  \implies 选用 二项分布;
  3. “不断重复试验,问第几次才首次出现成功”   ⟹  \implies 选用 几何分布;
  4. “针对一个有限总体进行‘不放回’地抽取样本”   ⟹  \implies 选用 超几何分布;
  5. “求解在一段确定时间或一个确定空间里,某随机事件发生的次数”   ⟹  \implies 选用 泊松分布;
  6. “随机变量在某个范围区间内的取值机会是均等的”   ⟹  \implies 选用 均匀分布;
  7. “研究某些产品设备的使用寿命,或者求两次随机事件发生的间隔等待时间”   ⟹  \implies 选用 指数分布;
  8. “物理测量的误差,大量独立小随机因素累积的结果”   ⟹  \implies 选用 正态分布;
  9. “推断正态总体的方差性质”   ⟹  \implies 选用 卡方分布;
  10. “总体方差未知,需要估计或检验正态总体的均值”   ⟹  \implies 选用 tt 分布;
  11. “比较两个正态总体的方差大小”   ⟹  \implies 选用 FF 分布。

8. 易混淆分布深入对比#

8.1 二项分布 与 超几何分布#

  • 二项分布:每次抽样是有放回的(或者总体无穷大),每次抽取时摸出目标物的概率 pp 保持恒定不变。
  • 超几何分布:每次抽样是不放回的,因为每一次抽走个体会影响下一次摸出目标物的概率。
  • 联系:当总体容量 NN 趋于无穷大时,不放回抽样和放回抽样差别极小,超几何分布在极限下收敛于二项分布。

8.2 二项分布 与 几何分布#

  • 二项分布:试验的次数是固定的(即常数 nn),随机变量是“成功的次数”。
  • 几何分布:试验的次数是随机变量(即试验一直做到成功为止),随机变量是“首次成功时的试验次数”。

8.3 泊松分布 与 指数分布#

  • 泊松分布:属于离散型随机变量,数的是在单位时间内事件发生的“次数”(如一小时内通过路口的车辆数)。
  • 指数分布:属于连续型随机变量,测量的是两次随机事件发生之间的“时间长短”(如等待下一辆车通过路口的时间)。

8.4 正态分布 与 tt 分布#

  • 正态分布:在总体方差 σ2\sigma^2 已知,或样本量较大(利用中心极限定理)时使用。
  • tt 分布:仅在总体服从正态分布,且总体方差 σ2\sigma^2 未知的小样本推断中使用。

9. 备考复习优先级建议#

  1. 第一梯队(核心考点,必须透彻掌握): 二项分布、泊松分布、正态分布(包含标准化计算与中心极限定理的结合)。
  2. 第二梯队(常考基础题): 均匀分布、指数分布(牢记无记忆性)、超几何分布。
  3. 第三梯队(统计推断必备): 卡方分布、tt 分布、FF 分布(熟练掌握它们与正态总体样本均值、样本方差的转换公式)。

10. 一句话总结各种分布#

两点一次成败,二项多次成败,几何首次成功,超几何不放回,泊松数次数,均匀区间等概率,指数等时间,正态看自然误差,卡方看方差,t 看方差未知均值,F 看方差之比。\boxed{\text{两点一次成败,二项多次成败,几何首次成功,超几何不放回,泊松数次数,均匀区间等概率,指数等时间,正态看自然误差,卡方看方差,} t \text{ 看方差未知均值,} F \text{ 看方差之比。}}
分享

如果这篇文章对你有帮助,欢迎分享给更多人!

常见概率分布
https://dawn114514.site/posts/概率论/常见分布/
作者
黎明
发布于
2026-06-24
许可协议
MIT

部分信息可能已经过时

目录